Integrăm AI în procese, care funcționează deja
Date, modele, integrare cu sistemele voastre și asistență după lansare.
AI nu este aici un produs separat, ci un strat de prelucrare peste datele pe care compania le acumulează deja: comenzi, solicitări, documente, mișcări de marfă, evenimente ale echipamentelor. Mai jos sunt direcțiile de implementare, fiecare descrisă printr-un singur circuit: ce date se iau, ce face modelul cu ele, ce decizie sau acțiune rezultă din asta și ce se schimbă în activitatea companiei.
Implementarea AI — este integrarea modelului într-un proces care funcționează deja, nu lansarea unui sistem separat alături de el. Modelul citește datele companiei, găsește în ele o regularitate și emite o decizie; acțiunea conform acestei decizii este executată de sistemul în care trăiește procesul — CRM, ERP, programul de depozit, casa de marcat, portalul, mesageria.
De aceea proiectul nu începe cu alegerea modelului, ci cu patru răspunsuri: ce date există și în ce stare sunt; ce decizie trebuie luată; cine și cu ce execută această decizie; după ce cifră se va vedea că a devenit mai bine. Fără oricare dintre cele patru, modelul adaugă încă o sursă de date de care nu răspunde nimeni.
Unde nu este nevoie de AI. Dacă regula se descrie într-un singur rând — «stocul sub cinci bucăți, se anunță achizițiile» —, ea se scrie ca regulă: este mai ieftină, previzibilă și verificabilă rând cu rând. AI este potrivit acolo unde criteriile sunt zeci, se schimbă în timp, iar omul decidea până acum «din ochi»: clasificarea unei solicitări, estimarea cererii, căutarea unei operațiuni atipice, extragerea câmpurilor dintr-un document de formă liberă.
| Sarcina | Cu ce se rezolvă |
|---|---|
| Anunțarea achizițiilor despre un stoc scăzut | regulă |
| Încadrarea unui e-mail primit la o temă și un departament | model |
| Aplicarea reducerii conform condițiilor contractuale | regulă |
| Estimarea cererii pentru o poziție cu o lună înainte | model |
| Verificarea completării câmpurilor obligatorii | regulă |
| Găsirea unei operațiuni atipice printre cele obișnuite | model |
Granița trece printr-un singur criteriu: se poate scrie condiția în întregime sau nu. Acolo unde se poate, regula funcționează mai repede, costă mai puțin și își explică singură decizia. Modelul este necesar acolo unde condiția se descrie prin exemple, nu printr-un rând. Într-un sistem real ele nu se contrazic, ci stau alături: modelul aduce intrarea neformalizată la o structură, mai departe decid regulile.
Pilotul se construiește pe date istorice și se compară cu nivelul de bază tot pe ele. Dacă modelul nu depășește modul actual de lucru pe perioada trecută, nu intră în exploatare industrială.
Prin acest circuit este descrisă fiecare direcție de mai jos. Tot el este și modul de a verifica orice propunere de implementare a AI: dacă în ea nu sunt numite toate cele patru verigi, este vorba despre o demonstrație de posibilități, nu despre un proces de lucru.
Ce se dă la intrare: comenzi și plăți, solicitări și corespondență, documente și scanuri, mișcări de marfă, evenimente ale echipamentelor, înregistrări ale sistemului contabil. Se indică sursa, adâncimea istoricului și frecvența actualizării.
Ce face modelul: încadrează obiectul într-o clasă, extrage câmpuri, estimează o valoare, găsește o abatere de la normă, ierarhizează variantele, formulează un răspuns pe baza documentelor găsite. Întotdeauna cu o cifră de certitudine.
Ce se întâmplă cu rezultatul: cererea pleacă în coada executantului, statusul se schimbă în CRM, sarcina ajunge la depozit, documentul se înregistrează, răspunsul se trimite clientului, cazul se transmite unui om.
Ce se măsoară: timpul operațiunii, ponderea deciziilor fără participarea omului, numărul de erori și de returnări la refacere, pierderile din întârzieri și casări, încărcarea pe tură. Comparația se face cu nivelul de bază dinaintea implementării.
Certitudinea clasificării — 0,94 la un prag de 0,80. Sub prag, solicitarea ar fi ajuns în coada generală cu o sugestie de temă, nu direct la departamentul de calitate: cazul disputat este analizat de om, nu de model.
Date în companie se află în locuri diferite și în stări diferite: o parte în baza sistemului contabil, o parte în e-mail și în mesagerii, o parte în fișiere, o parte vine de la echipamente. Cât timp colectarea se face manual, orice analiză descrie nu afacerea, ci ceea ce s-a apucat să fie exportat.
Prelucrarea AI: din flux se extrag entitățile — partenerul, produsul, documentul, evenimentul; înregistrările despre unul și același obiect se leagă între ele, chiar și atunci când denumirile și scrierea nu coincid. Potrivirea denumirilor, adreselor și datelor de identificare nu este o sarcină de comparare a șirurilor, ci una de model.
Ce se conectează:
Acțiunea: ce s-a colectat se depune într-un buffer de date brute, unde nimic nu se suprascrie, și abia apoi se distribuie către vitrine, modele și rapoarte. Înregistrarea inițială poate fi oricând scoasă și verificată.
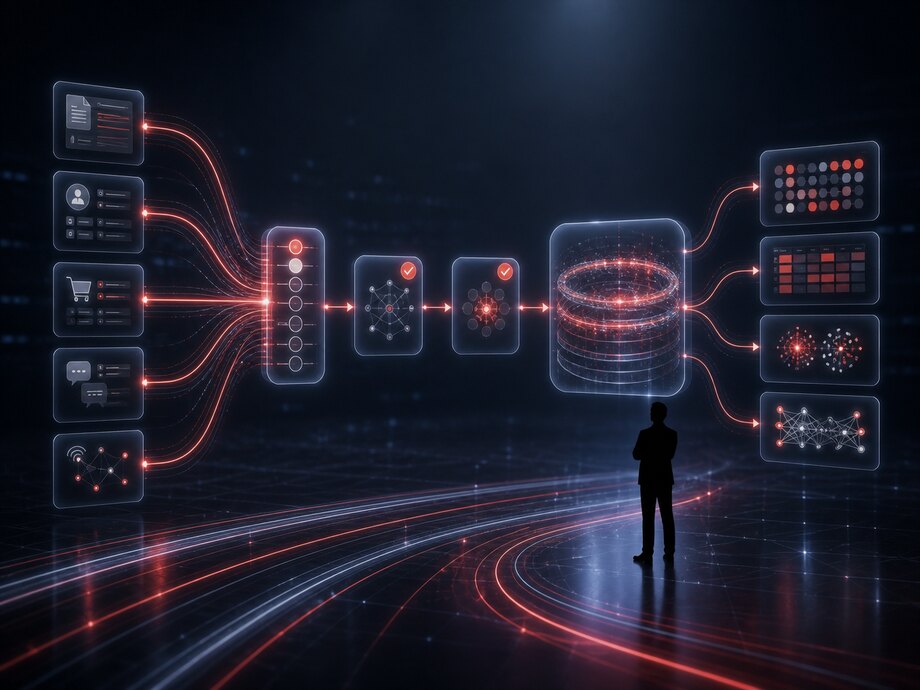
Datele pentru analiză și modele apar fără exporturi manuale și fără «versiunea de tabel a fiecărui departament». Colectarea manuală se transformă dintr-o muncă zilnică într-o excepție, iar diferențele dintre rapoarte se analizează după jurnalul de încărcare, nu după memoria angajaților.
Datele colectate nu sunt gata de utilizare: una și aceeași poziție se numește în trei feluri, unitățile de măsură sunt încurcate, jumătate dintre înregistrări nu au un atribut obligatoriu, iar o parte dintre rânduri sunt duplicate ale aceleiași operațiuni. Un model antrenat pe un astfel de set va reproduce dezordinea, nu va găsi regularitatea.
Prelucrarea AI acoperă aici trei sarcini: aducerea înregistrărilor la o formă unitară, completarea atributelor acolo unde lipsesc și repartizarea obiectelor pe categorii care nu existau în datele inițiale.
Acțiunea: corecțiile sigure se aplică automat și se scriu în jurnal cu valoarea inițială; cele disputate ajung la confirmare la proprietarul nomenclatorului într-o singură listă, nu prin scrisori una câte una.
Calitatea datelor nu este o curățenie de o singură dată, dinaintea proiectului, ci un proces permanent: nomenclatoarele se completează în fiecare zi, furnizorii schimbă formatele listelor de prețuri, managerii creează fișe din nou în loc să o caute pe cea existentă. De aceea regulile și modelele de curățare trăiesc în sistem împreună cu datele și se aplică la fiecare încărcare.
Fiecare corecție are un autor — o regulă sau un model —, o oră, o valoare veche și una nouă. Nu este birocrație: fără istoric este imposibil de analizat de ce raportul pe luna trecută arată astăzi alte cifre.
Nomenclatoarele nu se mai ramifică, rapoartele pe grupe de produse și pe articole de cheltuieli se potrivesc între ele, iar pregătirea datelor nu mai mănâncă cea mai mare parte din termenul oricărui proiect analitic.
| Verificare | Rânduri | Total |
|---|---|---|
| Potrivite cu nomenclatorul | 4 812 | aplicate |
| Unitățile de măsură aduse la formă unitară | 1 106 | aplicate |
| Categoria completată după descriere | 438 | aplicate |
| Fișe asemănătoare, necesită decizie | 96 | în verificare |
| Contradicții în document | 14 | retur către furnizor |
Captură a ecranului sistemului: cifrele sunt demonstrative. La verificare au fost scoase doar cazurile aflate sub pragul de certitudine — 96 din 6 466 de rânduri, restul s-a aplicat automat, cu scrierea valorii anterioare în jurnal.
Un raport obișnuit răspunde la întrebarea care i-a fost pusă: venitul pe luni, vânzările pe filiale, stocurile pe depozite. Întrebările le pune omul, de aceea se vede exact ceea ce cineva s-a gândit să se uite.
Prelucrarea AI schimbă aici direcția: modelul parcurge singur secțiunile și aduce acele felii în care comportamentul indicatorului diferă de cel așteptat. Nu «desenează-mi un grafic», ci «iată trei locuri în care se întâmplă altceva decât de obicei și iată cu ce este legat asta».
Ce face analiza inteligentă:
Acțiunea: descoperirea nu rămâne în tabloul de bord — ea se transformă într-o sarcină cu destinatar și termen: de analizat punctul cu scădere, de contactat clientul din grupa de risc, de verificat categoria cu creșterea returnărilor.
Modelul arată legătura, nu cauza. Creșterea returnărilor într-o categorie poate fi explicată de un lot cu defecte, de schimbarea furnizorului, de o eroare în descrierea produsului sau de un canal nou de vânzări, cu alt public — alegerea explicației și decizia rămân la om.
De aceea fiecare descoperire are în interfață trei lucruri: pe ce date este construită, cât de puternică este abaterea și ce secțiuni a verificat modelul. O concluzie care nu poate fi desfășurată până la rândurile inițiale nu se ia în lucru.
Analiza încetează să mai fie un raport lunar citit după închiderea perioadei. Abaterea se găsește în aceeași zi, se analizează la cald și costă mai puțin decât atunci când este observată într-o secțiune trimestrială.
Anomalia nu este orice valoare rară, ci abaterea de la norma proprie a obiectului. Pentru un punct de vânzare douăzeci de bonuri pe oră este o zi obișnuită, pentru altul — un motiv de verificare. Norma se calculează după istoricul fiecărui obiect și după grupa comparabilă, nu după o medie generală.
Datele: istoricul indicatorului pentru obiect. Prelucrarea: modelul construiește coridorul așteptat, ținând cont de ziua săptămânii, sezon și promoții. Acțiunea: ieșirea din coridor creează o sarcină de analiză. Rezultatul: prăbușirea vânzărilor sau o eroare de evidență se vede în ziua în care s-a produs.
Datele: plăți, reduceri, returnări, anulări, corecții manuale ale documentelor. Prelucrarea: se evaluează combinația de criterii — suma, ora, angajatul, frecvența. Acțiunea: operațiunea pleacă în coada de control. Rezultatul: abuzurile și erorile se analizează înainte de închiderea perioadei.
Datele: telemetria dispozitivelor și a terminalelor. Prelucrarea: se caută schimbarea caracterului evenimentelor înaintea defecțiunii. Acțiunea: dispozitivul intră în traseul de mentenanță. Rezultatul: o parte dintre defecțiuni se înlătură înainte de oprirea din funcțiune, nu după reclamație.
Datele: înregistrări contabile, stocuri, inventarieri, transferuri. Prelucrarea: se compară fluxurile care sunt obligate să se potrivească. Acțiunea: diferența se consemnează, cu un responsabil. Rezultatul: lipsurile se găsesc punctual, nu ca sumă globală la finalul trimestrului.
Datele: istoricul comenzilor, solicitărilor și plăților. Prelucrarea: modelul observă ruperea ritmului obișnuit al cumpărăturilor. Acțiunea: clientul ajunge în lista managerului. Rezultatul: plecarea clientului se vede înainte ca el să fi încetat definitiv să cumpere.
Datele: marcajele de timp ale etapelor comenzii, cererii, reparației. Prelucrarea: se găsesc etapele cu timp în creștere și caracteristicile lor. Acțiunea: etapa se scoate la analiză, cu cifre. Rezultatul: termenul de execuție se scurtează acolo unde se pierde cu adevărat timp.
| Obiectul | Ce nu este în regulă | Se aștepta | Faptic | Stare |
|---|---|---|---|---|
| Punctul nr. 14 | Venit sub coridor a treia zi | 98–126 mii | 61 mii | analiză |
| Depozitul «Sudic» | Ponderea corecțiilor manuale de stoc | până la 1,5% | 6,2% | analiză |
| Terminalul T-207 | Creșterea erorilor modulului de plată | 0–2 pe zi | 17 | în traseu |
| Categoria «Produse chimice de uz casnic» | Returnări peste norma categoriei | până la 2,1% | 5,8% | așteaptă |
Captură a ecranului sistemului: cifrele sunt demonstrative. Fiecare rând se desfășoară până la operațiunile inițiale — o abatere fără posibilitatea de a ajunge la datele primare nu intră în coadă.
Planificarea după luna trecută greșește previzibil: ea nu știe nici de sezon, nici de promoție, nici de faptul că poziția a lipsit din depozit două săptămâni, iar vânzări nu au fost nu pentru că nu există cerere.
Datele: istoricul vânzărilor pe poziție și punct, perioadele de lipsă a produsului, prețurile și promoțiile, calendarul — weekenduri, sărbători, începutul anului școlar, vremea acolo unde ea influențează cererea, datele despre livrări și termene.
Prelucrarea AI: modelul estimează cererea viitoare pentru fiecare pereche «poziție — punct» și arată separat dispersia: nu o singură cifră, ci un interval cu probabilitate. Pentru planificarea stocului contează mai mult limita superioară, pentru planificarea venitului — mijlocul.
Ce se prognozează:
Acțiunea: prognoza nu rămâne o simplă informare — ea ajunge în cererea de achiziție, în planul de reaprovizionare a punctelor, în graficul turelor și în limitele pe clienți. Rezultatul: mai puține vânzări pierdute din cauza raftului gol și mai puțini bani blocați într-un stoc în plus.

Modelul nu se verifică pe datele pe care a învățat: istoricul se împarte în timp, antrenarea se face pe segmentul timpuriu, verificarea — pe cel târziu. Astfel se reproduce situația reală, în care viitorul este necunoscut.
Precizia se calculează permanent, nu o singură dată la lansare: fiecare rând de prognoză se compară cu faptul, atunci când perioada se închide. Creșterea erorii este un semnal că, ori comportamentul cererii s-a schimbat, ori modelul trebuie reantrenat.
Captură a ecranului sistemului: cifrele sunt demonstrative. Grupele cu eroare mare nu se ascund, ci se scot separat: pentru ele comanda o calculează omul, sprijinindu-se pe interval, nu pe o singură cifră.
Rutina înseamnă operațiunile care se repetă de zeci de ori pe zi, cer atenție și nu cer calificare: mutarea datelor dintr-un e-mail într-o fișă, încadrarea unei plăți la un articol, desemnarea unui executant, verificarea completitudinii unui document, punerea unui status.
Prelucrarea AI este necesar acolo unde intrarea nu este formalizată: e-mailul este scris în cuvinte, documentul a venit într-un format străin, cererea este formulată diferit de fiecare client. Modelul aduce o astfel de intrare la o structură, după care de proces se ocupă regulile obișnuite — previzibile și verificabile.
Ce trece în regim automat:
Acțiunea și rezultatul: operațiunea este executată de sistem și se scrie în jurnal cu autor, oră și valoare inițială. Angajatul trece de la introducerea datelor la analiza excepțiilor — acele cazuri în care modelul nu este sigur sau în care prețul erorii este mare.
Acțiunea automată este admisă acolo unde poate fi anulată sau acolo unde eroarea costă puțin: punerea unui status, desemnarea unui executant, crearea unei ciorne. Operațiunile ireversibile — retragerea banilor, înregistrarea documentului, expedierea — rămân în seama omului sau cer confirmare.
Pragul de certitudine se stabilește separat pentru fiecare operațiune și se schimbă pe măsura acumulării statisticii. Se începe de obicei cu un prag înalt și cu regimul de sugestie: modelul propune, omul confirmă — iar pe aceste confirmări se vede unde i se poate acorda încredere.
Datele: avize de însoțire, facturi, procese-verbale, contracte, specificații, ordine de plată, cereri, cărți tehnice ale echipamentelor, e-mailuri cu atașamente. Formatele sunt diferite: pdf, fotografie de pe telefon, scan, fișier de export, original pe hârtie.
Prelucrarea AI: recunoașterea textului, determinarea tipului de document, extragerea câmpurilor și a părților tabelare, potrivirea pozițiilor cu nomenclatorul și legarea documentului de o comandă, un contract sau un partener. Pentru fiecare câmp se returnează valoarea și certitudinea în ea.
Ce se extrage:
Acțiunea: documentul se confruntă cu comanda și cu factura, diferențele se scot într-o listă, iar documentul ori se înregistrează, ori pleacă la analiză către un angajat anume. Rezultatul: introducerea documentelor încetează să mai fie o atribuție de serviciu separată, iar diferențele se găsesc înainte de plată, nu la închiderea lunii.
Recunoașterea nu dă o precizie de sută la sută pe niciun set de documente — și nici nu trebuie. Sensul este altul: sistemul arată căror câmpuri le acordă încredere și pe care cere să le confirmați. Operatorul verifică câteva câmpuri evidențiate, în loc să tasteze documentul în întregime.
Calitatea slabă a originalului nu este un motiv pentru o eroare tăcută: fotografia neclară, pagina tăiată, a doua pagină lipsă a specificației se marchează explicit și se returnează expeditorului, cu indicarea motivului.
Viteza prelucrării încetează să depindă de volumul fluxului primit, iar contabilitatea și aprovizionarea văd starea documentelor într-o singură listă, nu în cutiile poștale ale unor angajați separați.
Captură a ecranului sistemului: cifrele sunt demonstrative. Documentul este propus spre înregistrare doar după decizia asupra ambelor marcaje — poziția nouă de nomenclator și livrarea incompletă cer confirmarea omului.
Datele: e-mailuri, cereri de pe site, mesaje în mesagerii, transcrieri ale apelurilor, corespondența în chatul de asistență, recenzii și note. Toate acestea sunt text de formă liberă, pe care până acum îl citea și îl sorta omul.
Prelucrarea AI: solicitarea se încadrează într-o temă și o subtemă, se determină urgența și tonalitatea, din text se extrag numărul comenzii, denumirea produsului, adresa și alte entități, iar solicitarea se leagă de istoricul clientului. Solicitările repetate pe același motiv se lipesc într-un singur caz.
Acțiunea: cererea ajunge în coada grupei de profil, cu câmpurile completate, termenul de reacție se calculează după urgență, solicitarea repetată urcă în prioritate, iar clientul primește confirmarea cu numărul și termenul așteptat.
Rezultatul: solicitările nu mai stau în cutia generală până dimineața, iar conducătorul nu vede «multe reclamații», ci o structură: pe ce teme crește fluxul, unde crește timpul de răspuns și ce produse generează solicitări repetate.
O solicitare izolată vorbește despre un caz, întregul flux — despre produs și proces. Clasificarea pe teme dintr-o perioadă arată ce anume provoacă întrebări: o instrucțiune neclară, o eroare în descrierea produsului, o defecțiune într-o etapă concretă a comenzii, o întârziere la un anumit serviciu de livrare.
De aceea temele nu se iau din cap: mai întâi solicitările se grupează automat după sens, apoi grupele rezultate se corectează manual și se fixează ca nomenclator. Mai departe el trăiește împreună cu produsul, iar grupele noi sunt propuse de sistem.
| Tema | Ponderea | Modificarea | Primul răspuns |
|---|---|---|---|
| Statusul și termenele de livrare | 31% | −4% | 6 min |
| Plata și returnarea banilor | 22% | +9% | 18 min |
| Disponibilitatea și caracteristicile produsului | 19% | −1% | 4 min |
| Funcționarea contului personal | 15% | +6% | 27 min |
| Reclamații de calitate | 13% | 0% | 41 min |
Captură a ecranului sistemului: cifrele sunt demonstrative. Cele două teme în creștere — plata și contul personal — nu ajung într-un raport, ci în sarcini pentru echipa de produs, cu exemple de solicitări.
Recomandarea este utilă acolo unde alegerea este largă, iar atenția scurtă: un catalog cu zeci de mii de poziții, sortimentul unui punct, un set de servicii, o selecție pentru manager înaintea unui apel. Datele pentru ea sunt istoricul comenzilor, vizualizările, componența coșurilor, returnările și stocurile; în rezultat intră obligatoriu disponibilitatea produsului, altfel sistemul recomandă ceea ce nu există.
Prelucrarea: din istoricul comenzilor se extrag combinațiile stabile de poziții. Acțiunea: selecția se afișează în fișa produsului și în coș. Rezultatul: crește numărul de poziții din bon, fără presiune asupra cumpărătorului.
Prelucrarea: modelul estimează probabilitatea interesului pentru o poziție după istoricul clientului și al clienților asemănători. Acțiunea: oferta pleacă în cont, în trimitere sau către manager. Rezultatul: reacția este mai bună decât la o trimitere generală, iar frecvența contactării clientului este mai mică.
Prelucrarea: interogarea se analizează după sens, nu după coincidența literelor: se iau în calcul sinonimele, greșelile de tastare și caracteristicile. Acțiunea: rezultatele se reordonează. Rezultatul: mai puține interogări fără rezultat și mai puține plecări din catalog.
Prelucrarea: se compară vânzările punctelor comparabile și mediul lor. Acțiunea: se propune scoaterea poziției din sortiment sau adăugarea ei. Rezultatul: raftul este ocupat de ceea ce se vinde exact aici.
Prelucrarea: înaintea contactului se adună istoricul clientului, întrebările deschise și pozițiile potrivite. Acțiunea: selecția se afișează în fișa din CRM. Rezultatul: pregătirea pentru apel durează un minut, nu zece.
Prelucrarea: se estimează termenul așteptat al cumpărăturii repetate a unei poziții consumabile. Acțiunea: reamintirea pleacă până la acel termen. Rezultatul: mai puține comenzi repetate ratate și mai puține atingeri fără sens.
Personalizarea este limitată de reguli explicite: ce nu se poate recomanda, ce date nu se folosesc, cât de des este admisibil să te adresezi clientului și cum dezactivează el selecția. Restricțiile se stabilesc în sistem, nu rămân o înțelegere pe cuvânt.
Viziunea artificială se justifică într-o clasă îngustă de sarcini: scena se repetă, obiectul este distinct, iar rezultatul se transformă imediat într-un eveniment contabil. Acolo unde aceste trei condiții nu sunt îndeplinite, camera dă o arhivă video și declanșări false, nu automatizare.
Unde funcționează:
Acțiunea: evenimentul recunoscut nu merge în arhivă, ci în evidență — în bon, în sarcină, în procesul-verbal de recepție, în jurnalul de abateri. Rezultatul: dispare consemnarea manuală a ceea ce oricum se întâmplă sub ochii camerei.

Sarcinile în care scena este de fiecare dată alta, iluminarea este arbitrară, iar prețul erorii este mare nu se acoperă cu camere. Recunoașterea emoțiilor, evaluarea «bunei-credințe» a angajatului, identificarea persoanei într-un flux general — acestea sunt ori nefiabile, ori limitate de lege, ori și una, și alta.
Acolo unde contează precizia, nu imaginea, funcționează mai ieftin și mai sigur alți senzori: cântarul, scanerul de coduri de bare, eticheta, încuietoarea cu jurnal. Camera se adaugă la ele, nu le înlocuiește.
Botul AI se deosebește de un chatbot pe scenariu printr-un singur lucru: el nu poartă utilizatorul printr-un arbore de butoane, ci înțelege întrebarea și execută o acțiune în sistem. Valoarea nu stă aici în conversație, ci în datele și operațiunile la care botul este conectat — catalogul, comenzile, cererile, CRM, baza de cunoștințe. Un bot fără acces la sisteme știe doar să repovestească instrucțiunea.
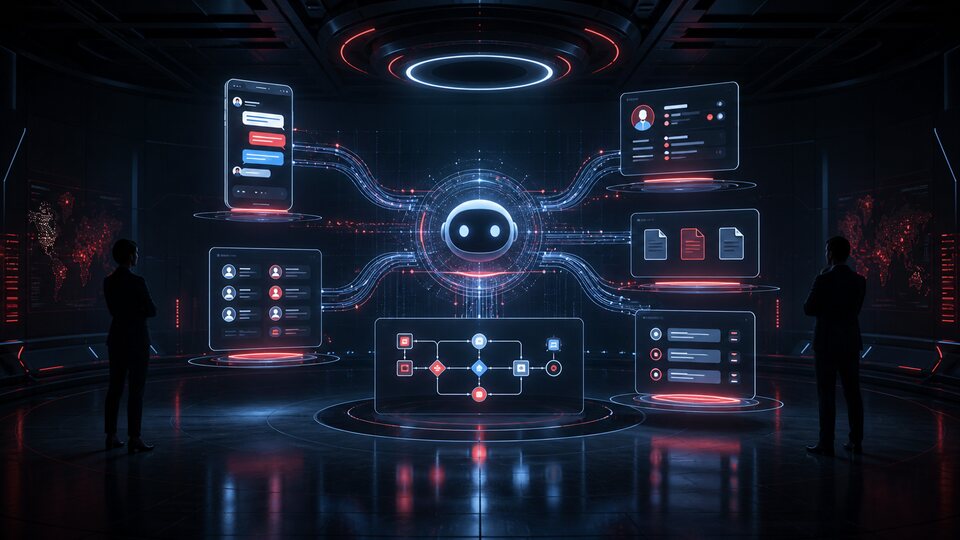
Datele: catalogul, prețurile, stocurile, condițiile de livrare și de plată, statusurile comenzilor. Prelucrarea: întrebarea se analizează după sens, iar răspunsul se construiește din date actuale, nu dintr-un text pregătit dinainte. Acțiunea: alegerea poziției, calculul livrării, plasarea sau modificarea comenzii. Rezultatul: întrebările tipice se rezolvă non-stop, iar managerii se ocupă de cele complexe.
Datele: baza de soluții, istoricul solicitărilor, configurația clientului, jurnalele sistemelor. Prelucrarea: simptomul se compară cu cazurile cunoscute. Acțiunea: instrucțiune pas cu pas, verificarea stării, crearea cererii cu datele deja adunate. Rezultatul: prima linie rezolvă cazurile repetitive, iar inginerul primește cererea cu diagnosticul făcut.
Datele: regulamente, ordine, instrucțiuni, nomenclatoare, rapoarte, disponibile angajatului conform drepturilor lui. Prelucrarea: căutare după sens și răspuns cu trimitere la punctul din document. Acțiunea: depunerea unei cereri la resurse umane sau la aprovizionare, solicitarea unei adeverințe, avizarea. Rezultatul: întrebările către colegi și în chaturile comune sunt înlocuite de un răspuns cu sursă.
Datele: textul solicitării, atașamentele, istoricul clientului. Prelucrarea: determinarea tipului de cerere, extragerea câmpurilor, verificarea completitudinii. Acțiunea: cererea se introduce în sistem, se solicită suplimentar datele lipsă, se desemnează executantul. Rezultatul: cererea ajunge la executant gata făcută, fără corespondență de dragul clarificărilor.
Datele: fișele clienților, tranzacțiile, sarcinile, istoricul contactelor. Prelucrarea: analiza solicitării managerului și a rezultatului discuției. Acțiunea: crearea și actualizarea fișei, consemnarea rezultatului contactului, punerea unei sarcini, adunarea unei sinteze despre client înaintea apelului. Rezultatul: CRM se completează în timpul lucrului, nu seara, din memorie.
Datele: contracte, specificații, regulamente, documentație tehnică, arhiva corespondenței. Prelucrarea: căutare după sens în loc de coincidența cuvintelor, iar răspunsul se construiește pe fragmentele găsite. Acțiunea: răspuns cu citat și trimitere la document, pagină și versiune. Rezultatul: răspunsul la o întrebare despre contract durează secunde și este verificabil la sursă.
Botul nu este un singur model, ci mai multe părți legate între ele. Separarea contează practic: fiecare parte are propriul motiv de defecțiune, propriile metrici și propriul mod de reparare.
Canalele de conectare sunt site-ul și contul personal, mesageriile, e-mailul, linia telefonică cu recunoașterea vorbirii, portalul intern și posturile de lucru ale angajaților. Logica rămâne însă una singură: canalul schimbă forma de introducere, nu ceea ce botului îi este permis să facă.
Botul nu «ține minte» documentele voastre — el le caută în momentul întrebării și răspunde după ce a găsit. De aceea actualizarea unui regulament are efect imediat după încărcarea lui, nu după reantrenarea modelului, și de aceea fiecare răspuns are o sursă.
Pasul 2 este obligatoriu: botul răspunde în limitele drepturilor celui care a întrebat. Un document indisponibil angajatului în sistem nu ajunge nici în căutare, nici în citat — altfel botul devine o cale de ocolire a sistemului de acces.
Mai întâi se adună un set de întrebări reale — din corespondență, solicitări și chaturile interne. Pe el botul este verificat înainte de lansare: răspunsurile se confruntă cu sursele, iar erorile se analizează după cauze. Abia după asta botul se deschide utilizatorilor, de obicei mai întâi unei singure grupe.
Riscul principal al unui bot AI este răspunsul greșit dat cu siguranță. El nu se înlătură prin promisiuni, ci prin construcția sistemului: un set limitat de operațiuni, sprijinul obligatoriu pe surse, praguri de certitudine și reguli explicite de escaladare.
Botul face doar ceea ce este descris în setul lui de acțiuni și în limitele drepturilor celui care i se adresează. Tot restul este indisponibil, chiar dacă utilizatorul insistă.
Răspunsul se construiește din documentele găsite și din datele sistemelor. Dacă sursa nu există, botul spune că nu știe și transmite întrebarea mai departe — acesta este un comportament normal, nu o defecțiune.
Sub prag, răspunsul nu se trimite clientului: el ajunge la operator ca ciornă, împreună cu materialele găsite. Pragul este propriu fiecărei teme.
Escaladare după reguli: temă închisă, întrebare repetată, reacție negativă, cererea clientului. Operatorul primește toată corespondența și materialele găsite, nu începe de la zero.
O acțiune ireversibilă — anularea comenzii, modificarea datelor de identificare, retragerea de bani — se execută doar după o confirmare explicită și se scrie în jurnal, cu inițiatorul.
Ponderea dialogurilor închise fără om, ponderea escaladărilor, notele utilizatorilor și verificarea prin sondaj a răspunsurilor. Erorile se întorc în setul de întrebări de verificare.
Separat se consemnează ce comunică botul despre el însuși: utilizatorul trebuie să înțeleagă că vorbește cu un program și să știe cum poate chema un om. Aceasta este o cerință față de interfață, nu o chestiune de setări.
Asistentul intern se deosebește de botul pentru clienți prin datele inițiale: el lucrează cu informația corporativă și în limitele drepturilor unui angajat concret. Una și aceeași întrebare pusă de gestionarul de depozit și de directorul financiar dă răspunsuri diferite — pentru că lor le sunt disponibile documente diferite.
Ce face asistentul la postul de lucru:
Rezultatul: angajatul își petrece timpul lucrând, nu căutând documentul necesar, amintindu-și regulamentul și completând formulare. Asistentul nu ia decizii în locul omului — el preia partea pregătitoare.
Asistentul se conectează la aceleași roluri ca și sistemele contabile: el nu creează un acces paralel. Documentele din afara drepturilor angajatului nu ajung nici în căutare, nici în citate, nici în sugestii — asta se verifică înainte de formarea răspunsului, nu după.
Acțiunile asistentului intră în jurnalul comun al sistemului la fel ca acțiunile oamenilor. În fișă se vede că sarcina a fost pusă de asistent în urma unei discuții, nu că a apărut o înregistrare fără autor.
Cunoștințele corporative stau rareori într-un singur loc: regulamentele într-un dosar, contractele în al doilea, documentația tehnică în al treilea, iar jumătate dintre răspunsuri — în corespondență. Căutarea după numele fișierului nu funcționează aici, pentru că omul nu caută un document, ci un răspuns.
Datele: regulamente și ordine, contracte și anexe, documentație tehnică și de proiect, instrucțiuni, baza solicitărilor rezolvate, procese-verbale, nomenclatoare, arhiva corespondenței — cu indicarea proprietarului și a nivelului de acces.
Prelucrarea AI: documentele se descompun în fragmente, fiecare fragment se indexează după sens; întrebarea se compară cu fragmentele, nu cu titlurile. Răspunsul se construiește din ce s-a găsit și este însoțit de citat, de trimiterea la document, la pagină și la versiune.
Acțiunea și rezultatul: angajatul primește răspunsul cu sursă în câteva secunde, în loc să facă turul colegilor; cazurile disputate se verifică după citat; documentele învechite se văd imediat — dacă răspunsul a venit dintr-o versiune veche de doi ani, asta este scris direct în răspuns.
Ea nu înlocuiește sistemul de circulație a documentelor și nu devine sursa adevărului: documentul cu valoare juridică rămâne acolo unde este semnat și păstrat. Indexul este modul de a-l găsi și de a-l cita, nu o copie separată care trăiește după propriile reguli.
Cererea vine în formă liberă și pe orice canal: e-mail, mesaj, formular pe site, apel, fișier atașat. Înainte de implementare, ea este citită de un om, care mută datele în sistem, stabilește tipul și desemnează executantul — pe asta se duc de la câteva minute până la câteva ore de așteptare la coadă.
Prelucrarea AI: se determină tipul cererii, se extrag câmpurile — obiectul, adresa, termenul, contactul, numărul contractului —, se verifică completitudinea, se evaluează urgența, iar cererea se leagă de client și de istoricul lui. Ce lipsește se solicită suplimentar, automat, pe același canal.
Acțiunea: cererea se introduce în sistem cu câmpurile completate, se desemnează grupa sau executantul conform regulilor, se stabilește termenul, se trimite confirmarea cu numărul. Duplicatele pe același motiv se leagă, în loc să dea naștere unei a doua cereri.
Rezultatul: executantul primește cererea gata făcută și începe cu munca, nu cu clarificările. Timpul de la primire până la desemnare încetează să depindă de cine și când a deschis cutia comună.
Captură a ecranului sistemului: datele sunt demonstrative. Cererile în care tipul a fost determinat cu o certitudine sub prag ajung la dispecer cu câmpurile precompletate și cu tipul sugerat — desemnarea rămâne în seama omului.
Date
Analiză și prognoză
Automatizarea
Boți și asistenți
Modelul aduce folos doar atunci când decizia lui ajunge la sistemul în care se execută munca. De aceea integrarea nu este etapa finală a proiectului, ci condiția lui: mai întâi se știe unde va ajunge rezultatul, apoi se antrenează modelul.
Cu ce se leagă stratul AI:
Modul de conectare se alege după sistem, nu după obișnuință: API direct, schimb printr-o coadă, webhook-uri pe evenimente, export de fișiere conform unei programări, citirea unei replici a bazei. Pentru sistemele fără interfață deschisă se folosește acel mod de schimb pe care îl au, inclusiv cel prin fișiere.
| Ora | Operațiune | Total |
|---|---|---|
| 11:02 | Clasificarea solicitărilor → CRM | 148 |
| 11:05 | Prognoza cererii → cerere de achiziție | 1 204 |
| 11:07 | Analiza avizelor de însoțire → sistemul contabil | 6 în verificare |
| 11:09 | Serviciul de depozit indisponibil | reluare peste 5 min |
Captură a ecranului sistemului: cifrele sunt demonstrative. Indisponibilitatea depozitului nu oprește celelalte schimburi — mesajele așteaptă în coadă și pleacă după restabilirea legăturii.
Implementarea AI înseamnă lucrul cu datele companiei, de aceea întrebarea «unde se execută modelul și ce pleacă în exterior» se rezolvă înainte de începerea proiectului, nu după lansare.
Circuitul se alege după sensibilitatea datelor: infrastructura proprie, un server dedicat sau un serviciu extern. Pentru o parte dintre sarcini, modelele deschise pe echipamentul propriu acoperă complet nevoia.
Dacă se folosește un model extern, componența câmpurilor transmise este descrisă explicit. Datele cu caracter personal și condițiile comerciale se anonimizează sau se înlocuiesc cu identificatori înainte de trimitere.
Stratul AI funcționează în limitele drepturilor utilizatorului și nu creează o cale ocolitoare către date. Verificarea accesului se execută înainte de căutare și înainte de formarea răspunsului.
Interogarea, sursele găsite, decizia modelului și acțiunea executată se scriu în jurnal. Fără asta nu se poate nici analiza un caz disputat, nici dovedi corectitudinea funcționării.
Deciziile cu consecințe juridice sau financiare rămân în seama omului. Modelul pregătește materialul și propune o variantă, iar confirmarea se consemnează cu autor.
Termenele de păstrare a dialogurilor, a seturilor de antrenare și a datelor intermediare se stabilesc dinainte. Ștergerea la cerere se extinde și asupra indexurilor de căutare, nu doar asupra bazei inițiale.
Modelul greșește întotdeauna — întrebarea este cât de des, unde anume și cât costă asta. De aceea fiecare implementare are două seturi de cifre: calitatea modelului în sine și schimbarea din proces. Primul îl interesează pe inginer, al doilea — afacerea, iar ele nu coincid automat.
Pragul de certitudine este o manetă de comandă, nu o constantă. Ridicându-l, compania obține mai puțină automatizare și mai puține erori; coborându-l — invers. Valoarea se alege după prețul erorii în procesul concret.
Captură a ecranului sistemului: cifrele sunt demonstrative. Cei trei indicatori se citesc doar împreună: creșterea automatizării la o pondere în creștere a corecțiilor înseamnă că pragul a fost coborât prea mult.
Modelul nu este o livrare de o singură dată. Datele se schimbă: apar produse noi, teme de solicitări, formate de documente, furnizori. De aceea în proiect se prevăd verificarea regulată a calității pe date proaspete, reantrenarea conform unei programări sau la atingerea pragului și analiza cazurilor în care omul a corectat decizia.
Corecțiile operatorilor sunt cel mai valoros material de antrenare: ele se adună într-un set separat și se folosesc la antrenarea următoare. Astfel sistemul se îmbunătățește pe propria activitate, nu pe date străine.
Ordinea reflectă dependențele: fiecare pas se sprijină pe ce a apărut la cel precedent. Omiterea primului pas este cel mai frecvent motiv pentru care un proiect cu AI se termină cu o demonstrație.
Ce operațiune se automatizează, cine o execută acum, ce date există și în ce stare sunt, unde va ajunge rezultatul. La ieșire — nivelul de bază în cifre și criteriul de succes.
Conectarea surselor, curățarea și etichetarea, vitrina de date pentru sarcină. Tot aici devine clar dacă istoricul este suficient pentru model sau dacă mai întâi trebuie acumulate date.
Antrenarea și verificarea pe o perioadă rezervată, comparația cu nivelul de bază, lansarea în regim de sugestie pe o parte din flux. Pragul de certitudine se alege pe deciziile reale ale operatorilor.
Integrarea cu sistemele, drepturile și jurnalele, monitorizarea calității și a derivei, reantrenarea conform programării, asistența. Extinderea către procesele vecine — în etape separate, cu măsurare.
Descrieți procesul pe care vreți să îl automatizați și ce date se colectează deja despre el. Vă vom răspunde ce se rezolvă aici prin reguli și integrare și unde este cu adevărat nevoie de un model.